 Γράφτηκε από τον Δημήτρη Ανδρεαδάκη
Συγκρίνουμε στην πράξη τα τρία κορυφαία open-source Marketing Mix Modeling εργαλεία σε Python και R, αναλύοντας priors, geo-lift calibration και απαιτήσεις data stack.
Αν ψάχνετε εργαλείο για open source marketing mix modeling, οι τρεις βασικές επιλογές σήμερα είναι το Meta Robyn, το Google Meridian και το παλαιότερο LightweightMMM. Σε αυτό το άρθρο τα συγκρίνουμε σε γλώσσα, engine, calibration και maintenance, και προτείνουμε ποιο ταιριάζει σε κάθε data stack. Το multi-touch attribution έχει χάσει μεγάλο μέρος της αξιοπιστίας του λόγω privacy αλλαγών και consent gaps, οδηγώντας όλο και περισσότερα data teams στο MMM. Το δίλημμα που αντιμετωπίζουμε σχεδόν σε κάθε project δεν είναι αν θα τρέξουμε MMM, αλλά ποιο engine θα σηκώσει το βάρος της ανάλυσης. Και η επιλογή αυτή καθορίζει ολόκληρη τη δομή του data pipeline. Αν δεν έχετε αποφασίσει ακόμη αν χρειάζεστε MMM, ξεκινήστε από το checklist για marketing mix modeling audit.
TL;DR:
- Το Google Meridian αποτελεί τον διάδοχο του LightweightMMM, προσφέροντας native Bayesian modeling σε Python με έμφαση σε geo-level δεδομένα και reach/frequency.
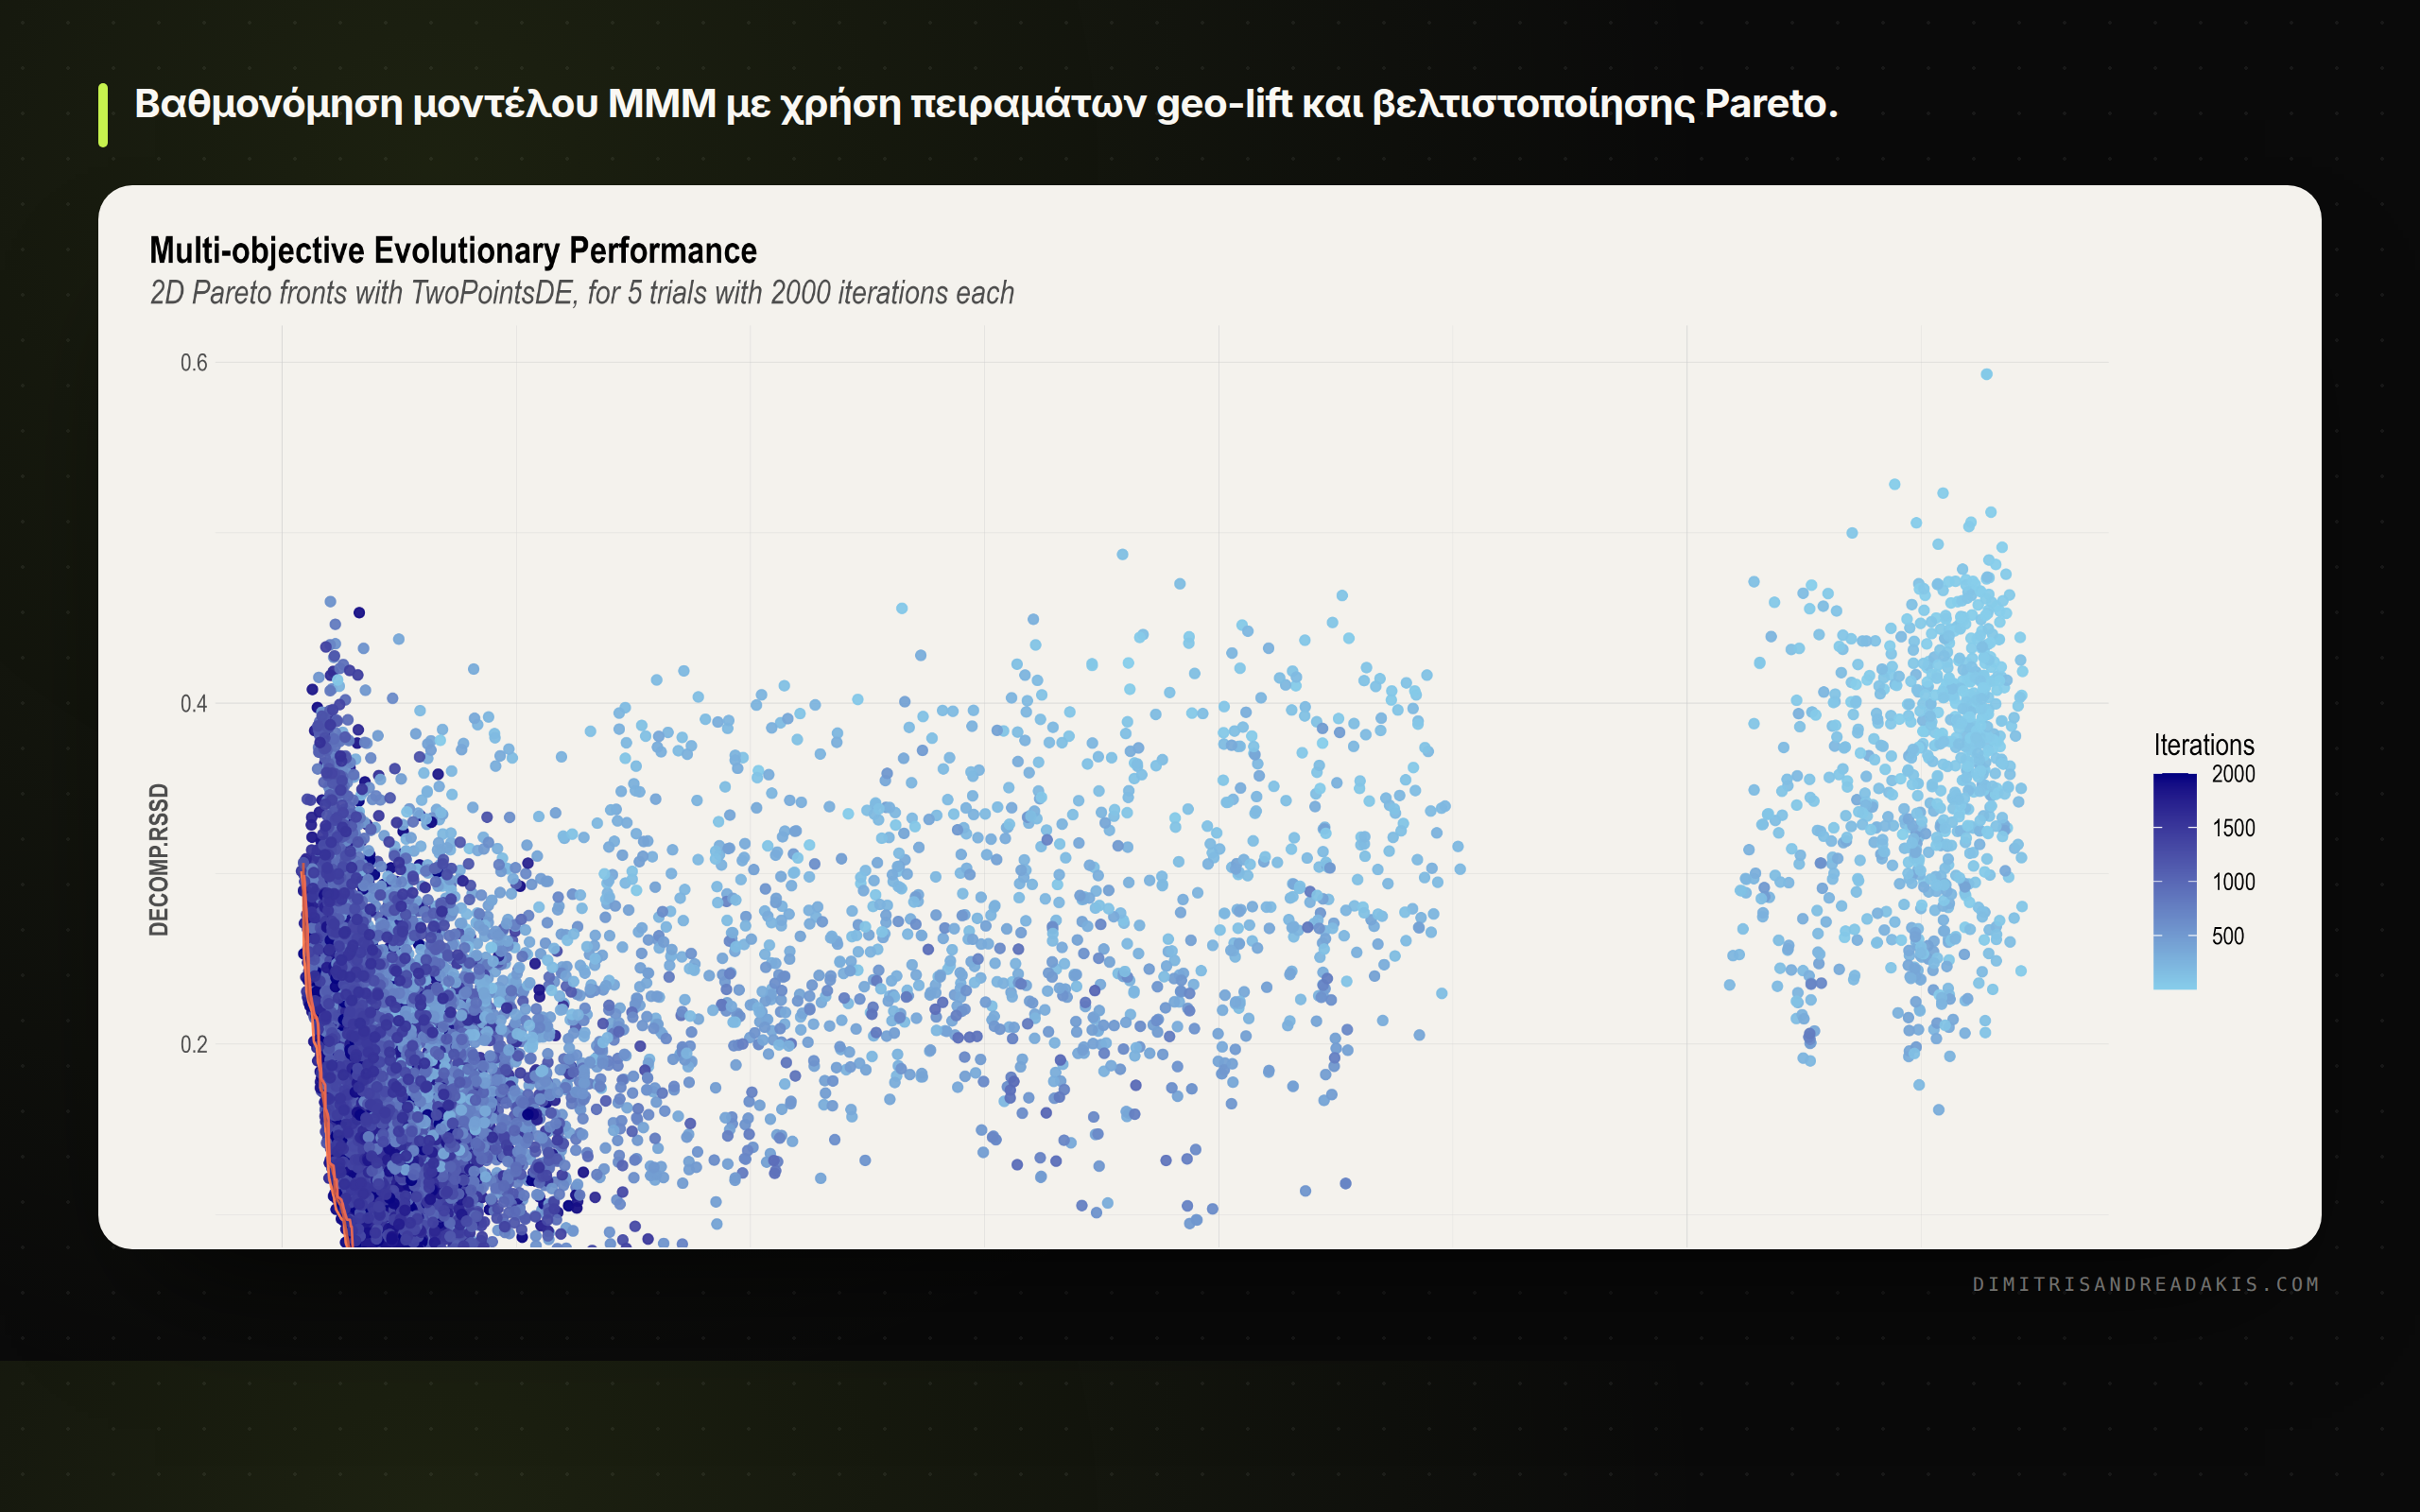
- Το Meta Robyn παραμένει εξαιρετικά ισχυρό σε R, χρησιμοποιώντας evolutionary multi-objective optimization (Nevergrad) και αυτόματο calibration.
- Για σύγχρονα Python data stacks η μετάβαση γίνεται ξεκάθαρα προς το Meridian, ενώ το Robyn παραμένει η σταθερή επιλογή αν η ομάδα σας δουλεύει αποκλειστικά σε R.
Γιατί το marketing mix modeling είναι απαραίτητο για cookieless measurement
Όταν τα ad platforms αποδίδουν τα ίδια conversions σε τρία διαφορετικά κανάλια ταυτόχρονα, χρειαζόμαστε μακροσκοπική εικόνα. Το MMM αναλύει συγκεντρωτικά δεδομένα (aggregated time series data) σε επίπεδο εβδομάδας ή ημέρας, παρακάμπτοντας εντελώς τα cookies και τα user-level identifiers. Συνδέοντας τα media spend data με τις συνολικές πωλήσεις και εξωγενείς παράγοντες (όπως εποχικότητα ή τιμολογιακές αλλαγές), παίρνουμε μια ρεαλιστική εκτίμηση του incremental impact.
Για να δουλέψει όμως σωστά ένα τέτοιο μοντέλο, πρέπει να συνδυαστεί με σωστά δομημένο first-party data tracking και αξιόπιστες πηγές δεδομένων. Κανένα μοντέλο δεν δίνει αξιόπιστα αποτελέσματα αν τα spend και revenue inputs είναι ελλιπή.
Meta Robyn vs Google Meridian vs LightweightMMM: Ο συγκριτικός πίνακας
Έχουμε δοκιμάσει και τα τρία frameworks σε διαφορετικά σενάρια media spend. Παρακάτω αποτυπώνουμε τις βασικές τεχνικές διαφορές τους:
| Κριτήριο | Meta Robyn | Google Meridian | LightweightMMM |
|---|---|---|---|
| Γλώσσα Προγραμματισμού | R | Python | Python |
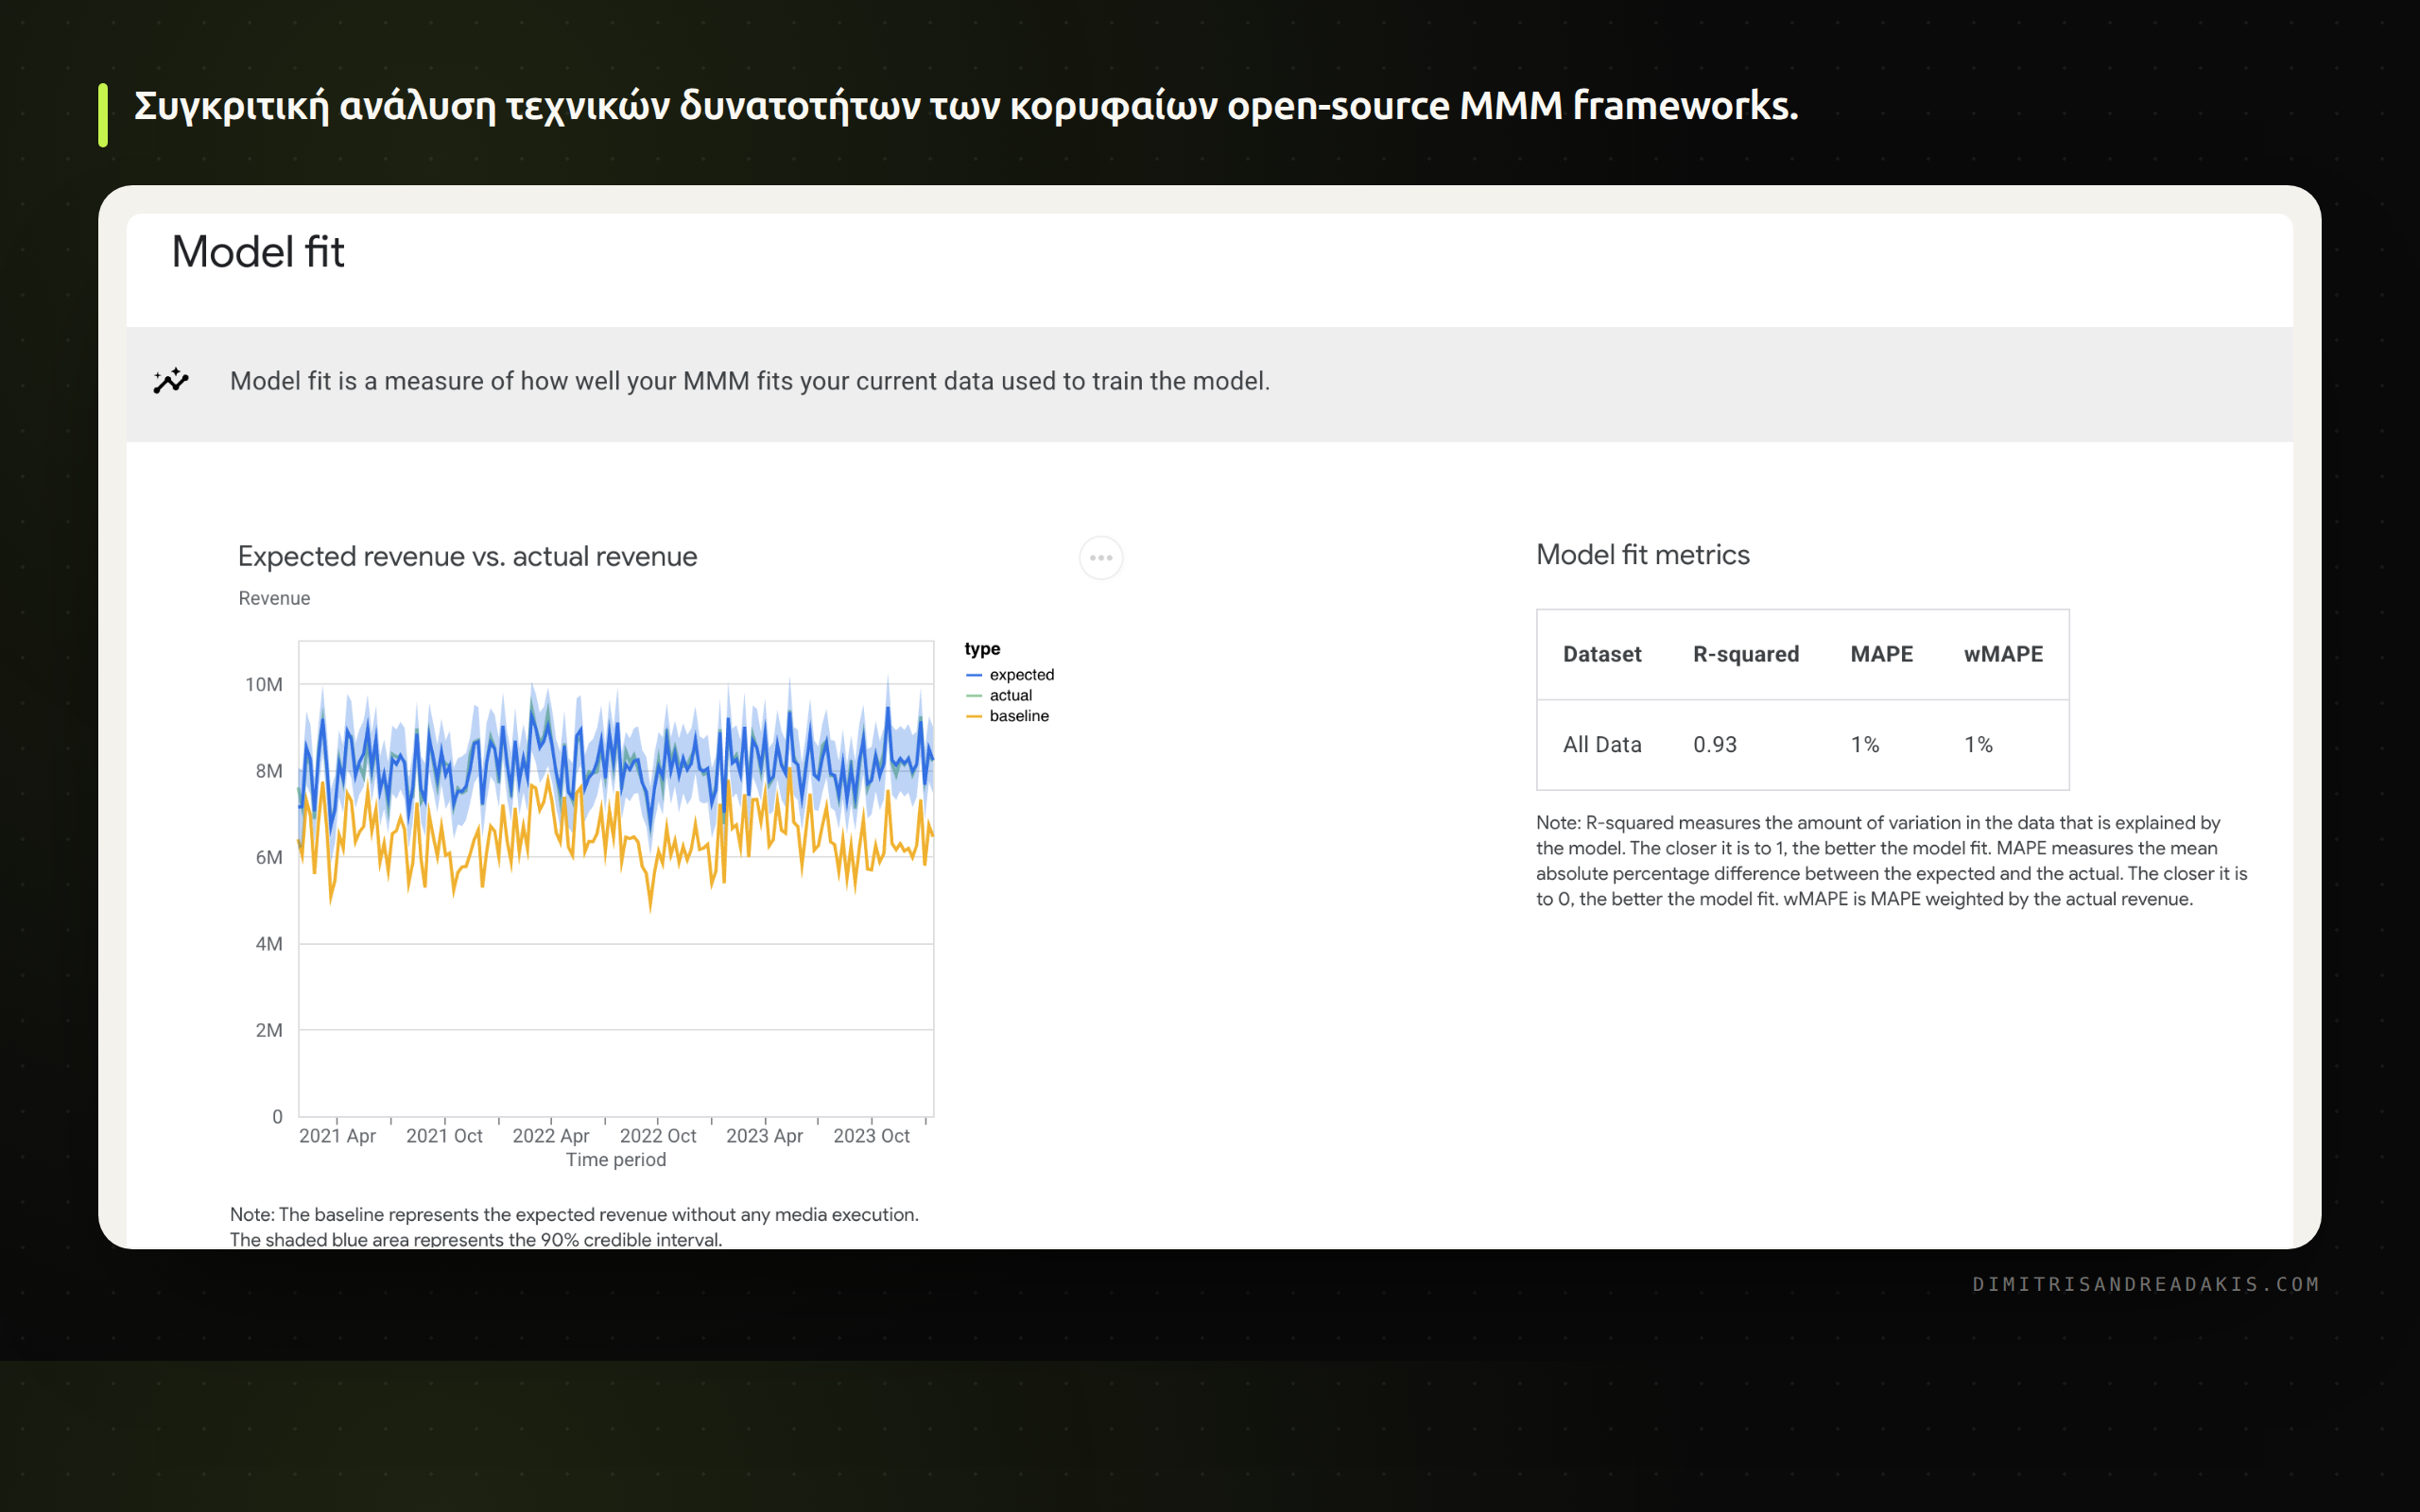
| Engine / Backend | Ridge Regression + Nevergrad | Bayesian (TFP / JAX) | Bayesian (Numpyro / JAX) |
| Geo-level Modeling | Περιορισμένο (κυρίως national) | Native (ιδανικό για DMA/Geo) | Υποστηρίζεται |
| Priors Support | Custom bounds (hyperparameters) | Πλήρη Bayesian Priors | Bayesian Priors |
| Calibration | Geo-lift / Incrementality tests | Geo experiments calibration | Custom integration |
| Reach & Frequency | Όχι (μόνο spend / impressions) | Ναι (native RF modeling) | Όχι |
| Status & Maintenance | Ενεργό (Meta) | Ενεργό (Google - νέο standard) | Deprecated (αντικαταστάθηκε) |
Python ή R: ποιο εργαλείο ταιριάζει στο modern data stack
Η επιλογή γλώσσας είναι συχνά το πρώτο πρακτικό φίλτρο. Το Meta Robyn είναι γραμμένο σε R, πράγμα που συχνά δημιουργεί τριβές όταν το υπόλοιπο analytics engineering pipeline σε BigQuery, dbt και Python orchestration (Airflow/Dagster) πρέπει να ενσωματώσει R scripts. Παρόλα αυτά, το Robyn παρέχει εξαιρετικά plotting utilities και automated hyperparameter tuning.
Από την άλλη πλευρά, το LightweightMMM έκανε δημοφιλές το Bayesian MMM στην Python κοινότητα, αξιοποιώντας το JAX για ταχύτατο Bayesian inference. Ωστόσο, η Google σταμάτησε την ενεργή ανάπτυξή του για χάρη του Meridian. Το Google Meridian είναι χτισμένο πάνω σε TensorFlow Probability, σχεδιασμένο από την αρχή για production περιβάλλοντα και seamless ενσωμάτωση με GCP pipelines.
Ένα MMM project δεν αποτυγχάνει στα μαθηματικά, αλλά στην αδυναμία του data team να ανανεώνει τακτικά τα μοντέλα μέσα από αυτοματοποιημένα pipelines.
Αν η υποδομή σας στηρίζεται σε scalable BI dashboards και reporting, η Python προσέγγιση του Meridian ενσωματώνεται σαφώς πιο ομαλά.
Πώς βελτιώνουν το MMM το geo-lift calibration και τα priors
Ένα κλασικό πρόβλημα των παλαιότερων οικονομετρικών μοντέλων ήταν το collinearity: όταν δύο διαφημιστικά κανάλια αυξάνουν το budget ταυτόχρονα (π.χ. Black Friday), το μοντέλο δυσκολεύεται να μοιράσει το credit. Εδώ έρχεται το calibration μέσω πειραμάτων.
Σύμφωνα με την επίσημη τεκμηρίωση για το Google Meridian open source MMM, η χρήση Bayesian priors σε συνδυασμό με geo-experiments επιτρέπει στο μοντέλο να «εκπαιδευτεί» πάνω σε πραγματικά lift tests. Αυτό μειώνει δραστικά την αβεβαιότητα στις παραμέτρους adstock και saturation.
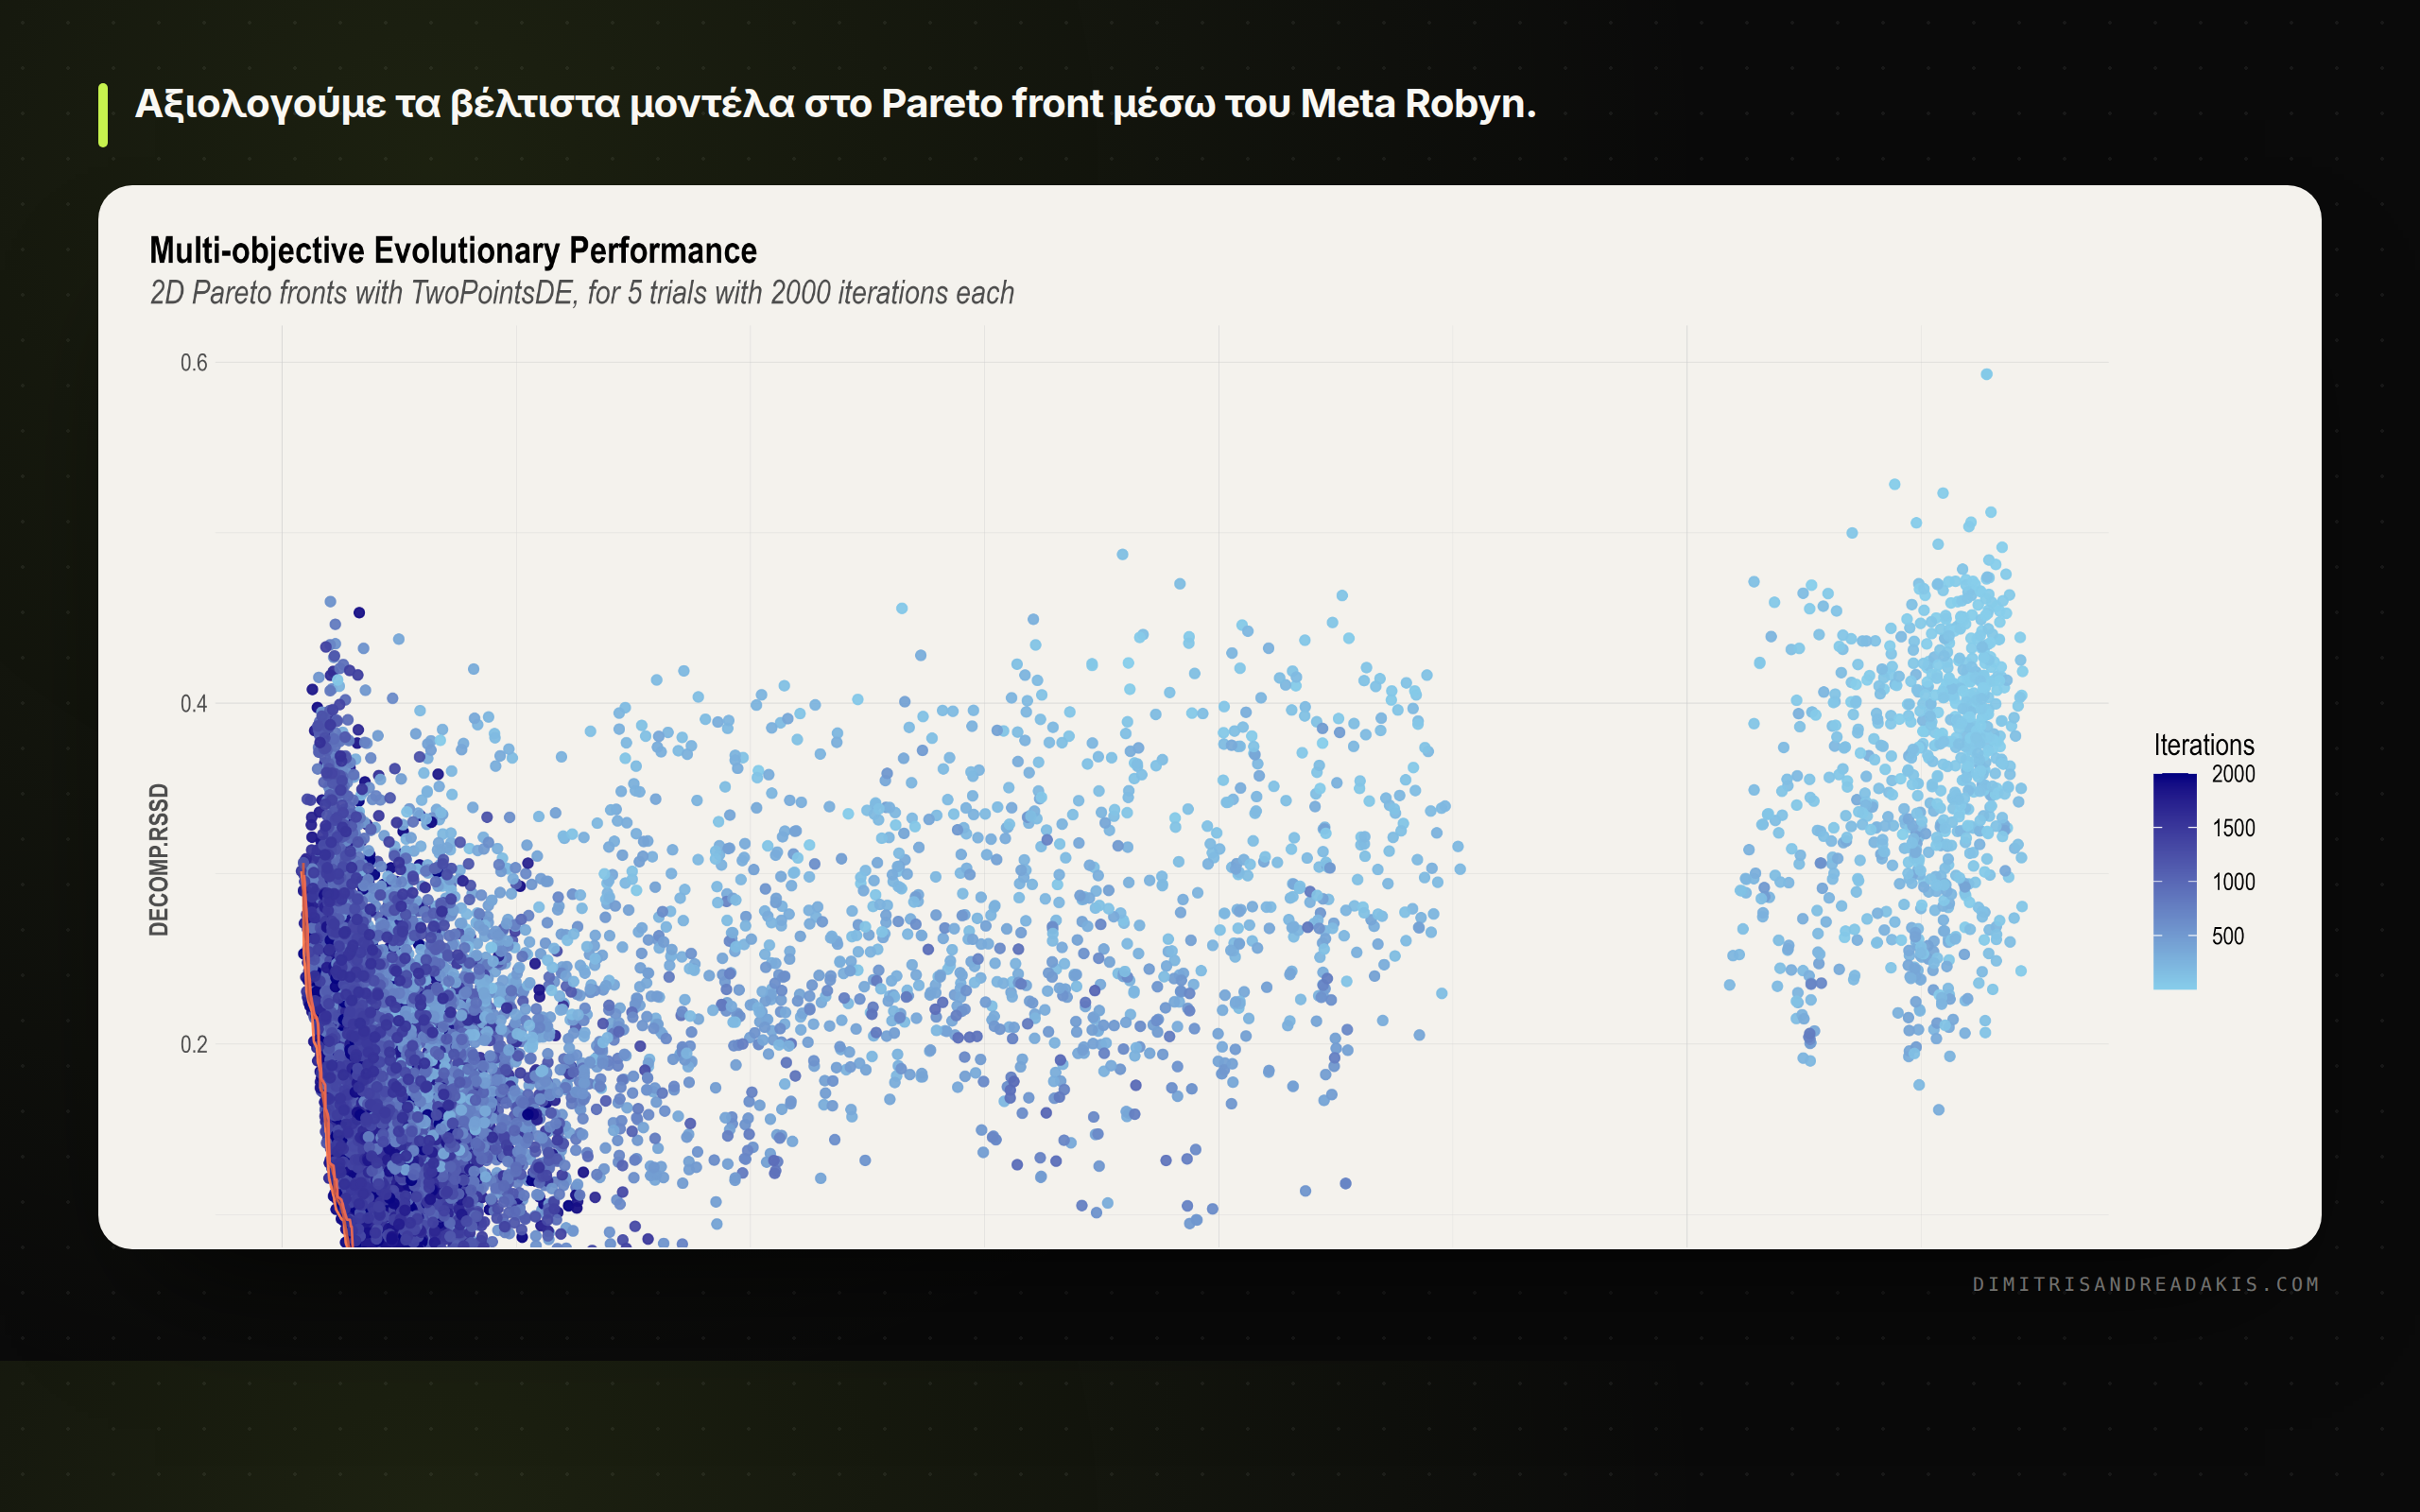
- Meta Robyn: Χρησιμοποιεί multi-objective optimization (Pareto front) ελαχιστοποιώντας ταυτόχρονα το prediction error (NRMSE) και το decomposition distance (DECOMP.RSSD), ενώ καλιμπράρει τα αποτελέσματα με geo-lift tests.
- Google Meridian: Επιτρέπει την εισαγωγή ROI priors από προηγούμενα lift studies απευθείας στη Bayesian κατανομή, δίνοντας ιεραρχικά αποτελέσματα τόσο σε εθνικό όσο και σε τοπικό επίπεδο.
Η δυνατότητα να τροφοδοτούμε το MMM με αποτελέσματα από πραγματικά A/B και geo-holdout tests είναι ο πιο αξιόπιστος τρόπος να περιοριστεί το media bias. Για το πώς σχεδιάζεται ένα τέτοιο πείραμα, δείτε τον οδηγό για incrementality testing με geo experiment.
Ποιο open source MMM εργαλείο να επιλέξετε
Μετά από εκτεταμένες δοκιμές, η στρατηγική επιλογής μας συνοψίζεται στα εξής βήματα:
- Αν ξεκινάτε τώρα νέο project σε Python: Επιλέξτε ξεκάθαρα το Google Meridian. Το LightweightMMM είναι πλέον legacy code, ενώ το Meridian έχει ανώτερη υποστήριξη για reach/frequency και geo-level ανάλυση.
- Αν η ομάδα σας έχει deep R expertise: Το Meta Robyn παραμένει ένα εξαιρετικά ώριμο, παραμετροποιήσιμο εργαλείο με εξαιρετικό visual output για media budget allocation.
- Αν έχετε έντονο offline αποτύπωμα ή TV spend: Το Meridian υπερέχει χάρη στη δυνατότητα απομόνωσης baseline οργανικών πωλήσεων και γεωγραφικών διακυμάνσεων.
Συχνές ερωτήσεις
Πόσα δεδομένα χρειάζονται για να τρέξει ένα Marketing Mix Model;
Χρειάζονται τουλάχιστον 2 χρόνια εβδομαδιαίων δεδομένων (104 παρατηρήσεις) για να απομονωθεί σωστά η εποχικότητα. Αν υπάρχουν διαθέσιμα geo-level δεδομένα (π.χ. ανά περιφέρεια ή πόλη), το μοντέλο μπορεί να εκπαιδευτεί αξιόπιστα ακόμα και με 6 έως 12 μήνες δεδομένων.
Είναι το LightweightMMM ακόμα κατάλληλο για production χρήση;
Όχι για νέα projects, καθώς η Google έχει σταματήσει την ενεργή συντήρησή του και προτείνει τη μετάβαση στο Meridian. Υπάρχοντα setups μπορούν να συνεχίσουν να τρέχουν, αλλά οι νέες δυνατότητες αναπτύσσονται αποκλειστικά στο Meridian ecosystem.
Μπορεί το MMM να αντικαταστήσει πλήρως τα conversion tracking pixels;
Όχι, λειτουργούν συμπληρωματικά. Το MMM χρησιμοποιείται για στρατηγική κατανομή budget και long-term media optimization, ενώ το conversion tracking είναι απαραίτητο για καθημερινό bidding και automated targeting στις ad platforms.
Η επιλογή του σωστού εργαλείου είναι το μικρότερο μέρος της δουλειάς· το μεγαλύτερο αφορά την ποιότητα των aggregated data και τη συνέπεια στα lift experiments που επικυρώνουν τα outputs. Επιλέξτε το framework που ταιριάζει στο tech stack σας και ξεκινήστε με απλά, ερμηνεύσιμα μοντέλα πριν προχωρήσετε σε πολύπλοκες Bayesian δομές. Αν θέλετε να σχεδιάσουμε μαζί το measurement strategy και το MMM setup σας, δείτε την υπηρεσία web analytics consulting και measurement strategy.